'데이터 선별과정·멀티모달 AI연구 방법', 국제학술지 게재
울산과학기술원(UNIST)은 인공지능대학원 김태환 교수팀이 AI 학습 데이터를 인간이 이해할 수 있는 '자연어'로 변환함으로써 AI 블랙박스를 설명하는 학습 방법론을 제안했다고 28일 밝혔다.
 |
| ▲ 왼쪽부터 김태환 교수, 김채리·배재연 연구원(제1저자) |
기존의 설명 가능한 인공지능(XAI) 연구는 주로 학습이 완료된 모델의 내부 연산 과정이나 예측 결과를 사후적으로 분석하는 데 집중했다. 반면 연구팀은 AI 학습의 원천인 '데이터'에 주목하여, 데이터의 특징을 설명문으로 구체화하고 이를 분석함으로써 모델의 의사결정 과정을 규명하고자 했다.
연구팀은 먼저 챗GPT와 같은 LLM 모델로 사진 속 사물의 특징을 여러 문장으로 설명하게 했다. 환각 현상 없는 고품질 설명문을 만들기 위해서는 인터넷 백과사전과 같은 외부 지식도 참고하도록 했다.
LLM이 생성한 수십 개의 설명 문장이 모두 모델 학습에 유효한 것은 아니다. 연구팀은 생성된 설명 중 AI 모델이 정답을 맞추는 데 실제로 참고한 설명문을 식별하기 위해 '텍스트 영향력 점수'(IFT·Influence scores For Texts)라는 정량적 분석 지표를 고안했다.
'IFT'는 두 가지 요소를 합산하여 계산된다. 특정 설명 문장을 학습 데이터에서 제외했을 때 모델의 예측 오차가 얼마나 변화하는지를 계산하여 학습 기여도를 측정하는 영향력 점수와, 텍스트 설명이 실제 이미지의 시각적 정보와 의미적으로 얼마나 일치하는지를 나타내는 CLIP 점수(CLIP Score)다.
예를 들어 조류 분류 모델에서 배경 색상에 대한 설명보다 '부리의 형태'나 '깃털의 무늬'를 묘사한 설명문이 높은 IFT 점수를 기록했다면, 해당 모델은 부리와 깃털의 특징을 학습해 대상을 식별했다고 해석할 수 있다.
연구팀은 이렇게 영향력이 큰 설명문들이 실제 모델이 정답을 맞추는 성능에도 도움이 되는지를 확인하기 위해 별도의 벤치마크 실험을 설계했다.
영향력이 높은 설명문을 모델 학습에 함께 제공하고 새로운 데이터셋에서 분류 작업을 수행하는, 교차 모달 전이 실험을 진행한 것이다. 그 결과, 영향력이 높은 설명문을 사용했을 때 기존 방식보다 안정적으로 높은 성능을 보였다. 이는 모델이 학습 과정에서 실제로 활용했던 설명이 성능에도 의미 있는 기여를 한다는 사실을 보여주는 검증 결과다.
김태환 교수는 "연구에서 제시한 AI가 스스로 자신이 학습하는 데이터를 설명하는 방식은 딥러닝의 복잡한 의사결정 과정을 본질적으로 드러내는 방법이 될 수 있다"며 "향후 블랙박스 AI 시스템을 투명하게 이해하는 기반이 될 것이다"라고 말했다.
연구 결과는 자연어처리(NLP) 분야 대표 국제학회인 EMNLP(Empirical Methods in Natural Language Processing)의 정식 논문으로 채택됐다. 올해 EMNLP는 11월 5일부터 9일까지 중국 쑤저우에서 열렸다.
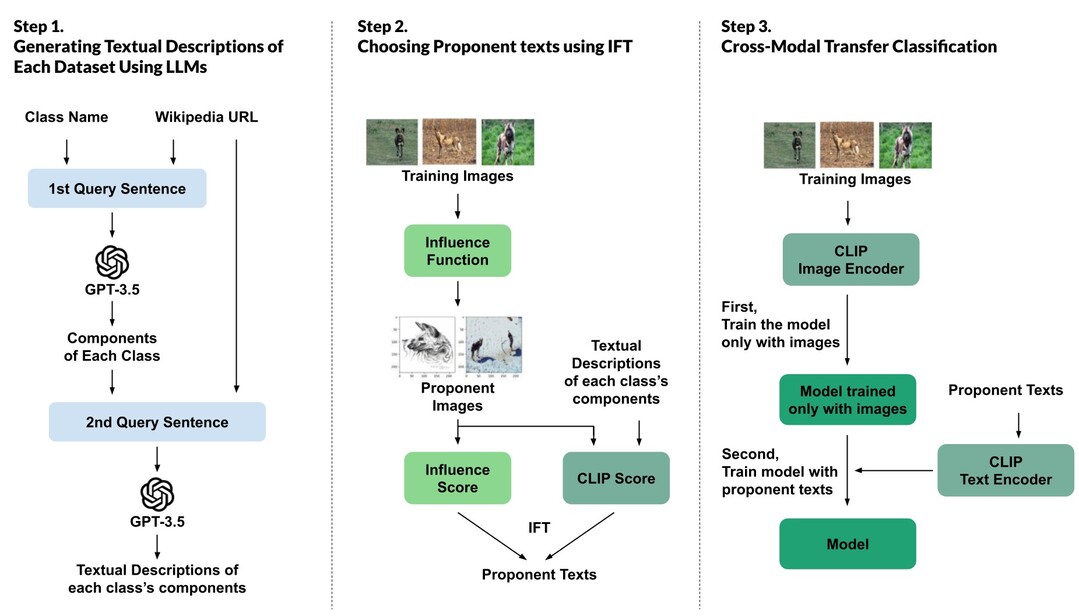 |
| ▲ 대형언어모델(LLM)을 활용한 데이터 설명문 생성 및 선별·학습 과정 개념도 |
KPI뉴스 / 최재호 기자 choijh1992@kpinews.kr
[저작권자ⓒ KPI뉴스. 무단전재-재배포 금지]