감정·상황·대화내용 복합영상 데이터, 한국어 기계독해 데이터 등 4종
한국 사람의 감정에 대한 영상 정보, 한국어의 자연스러운 발성정보를 담고 있는 인공지능(AI)용 데이터가 개방된다.
한국정보화진흥원(원장 문용식, 이하 NIA)은 14일, 250만개의 인공지능 학습용 데이터를 공개했다고 밝혔다. 공개된 데이터는 △ 감정, 상황, 대화내용을 담고 있는 복합 영상 데이터 △ 자연스러운 한국어 대화 음성 데이터 △ 한국어 챗봇용 대화 및 시나리오 데이터 △ 한국어 기계독해 데이터 4종이다.
이번 데이터 개방이 인공지능기술의 활용 스펙트럼을 넓히고, 관련 AI 서비스의 상용화를 촉진하는 계기가 될 것으로 전망된다.
데이터는 NIA가 운영하는 AI허브 홈페이지에서 간단한 회원가입을 통해 누구나 내려받아 사용할 수 있다.
공개된 AI 데이터별 활용 가능 서비스로는 △ 복합영상(멀티모달) 데이터: 사람의 표정과 대화 속에 내포된 감정을 읽고 사람과 공감하면서 대화하는 AI로봇의 개발 △ 한국어 음성 데이터: 2∼3명이 서로 자연스럽게 연속하여 발화하는 음성데이터로 기존 한국어 AI음성 인식기술 성능 향상 △한국어 대화 데이터: 음식점, 소매점, 학원 등 소상공인 업종에서 자주 발생하는 상황과 질문‧답변을 데이터로 제공하여 AI 챗봇 개발에 활용 △ 한국어 기계독해 데이터: 다양한 질문과 정답의 쌍을 AI에 딥러닝시켜 전후 맥락을 짚어 정확한 답변을 찾아 제공하는 AI로봇 개발 등이다.
현재 데이터의 확보가 AI 경쟁력이지만 대다수의 중소.벤처.스타트업은 많은 비용과 시간이 소요되는 데이터 구축에 어려움을 겪고 있다. 따라서 '인공지능 데이터 구축‧공개 사업'은 AI 시장에 막 진입하고자 하는 신생기업들에 매력도가 높은 사업이다.
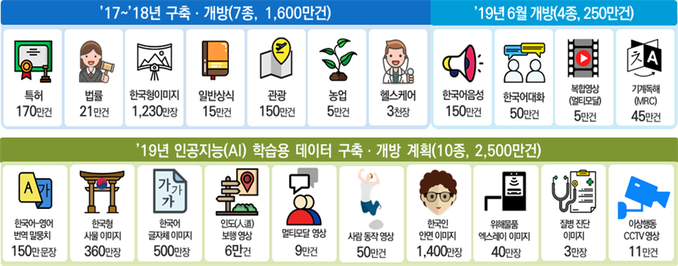
그간 정부는 2017년부터 법률, 특허, 일반상식, 한국형 이미지 4종의 데이터셋 구축을 시작해 2019년 1월에는 관광, 농업, 헬스케어 등 7종을 개방했고, 6월에 한국어 음성 등 4종을 추가 개방했다.
올해 말에는 한-영 번역말뭉치, 한국형 사물이미지, 한글 글자체 이미지, 이상행동 영상 등 10종 2,500여만건의 데이터셋을 대량 공개할 예정이다.
또한 국가 연구개발(R&D) 과제인 지능정보 플래그십 사업 등을 통해 만들어진 인공지능 학습용 데이터 다수를 올해 7월 AI허브에 공개할 예정이다. 지능정보 플래그십 사업은 음성‧언어‧영상 등 다양한 정보를 복합적으로 학습해 사람과 상호작용하는 대화형 에이전트 기술 및 서비스를 개발하는 AI분야 연구개발(R&D) 사업이다.
NIA 문용식 원장은 "인공지능 제품과 서비스가 활발히 개발되고 출시될 수 있도록 수요에 꼭 맞는 데이터셋을 대량 구축‧공개해 국내 인공지능 산업과 시장의 경쟁력을 강화하는데, 역량을 집중하겠다"고 밝혔다.
KPI뉴스 / 이제은 기자 lsy@kpinews.kr
[저작권자ⓒ KPI뉴스. 무단전재-재배포 금지]